| 일 | 월 | 화 | 수 | 목 | 금 | 토 |
|---|---|---|---|---|---|---|
| 1 | 2 | 3 | 4 | 5 | ||
| 6 | 7 | 8 | 9 | 10 | 11 | 12 |
| 13 | 14 | 15 | 16 | 17 | 18 | 19 |
| 20 | 21 | 22 | 23 | 24 | 25 | 26 |
| 27 | 28 | 29 | 30 |
- 자바스크립트
- 자바
- 마이그레이션
- SpringBoot4
- 코테
- java
- SWEA
- spring
- 마이라이트
- 가벼운학습지
- 일본어학습지
- 삼성
- 근로기준법
- javascript
- 백엔드
- 프로그래머스
- 코딩테스트
- springboot
- 일본어독학
- 일본어공부
- 에러해결
- restapi
- 생활정보
- js
- 코딩
- 가벼운학습지후기
- React Native
- 성인학습지
- jpa
- 알고리즘
- Today
- Total
개발에 AtoZ까지
[MySQL] 인덱스를 만들었는데 안 타는 5가지 경우 — EXPLAIN 한 줄로 확인합니다 본문
느린 쿼리를 찾아 인덱스를 걸었습니다. 그런데 실행 시간이 그대로입니다. 이럴 때 인덱스를 하나 더 만드는 건 대개 답이 아닙니다. 지금 있는 인덱스를 왜 안 쓰는지가 먼저입니다.
확인은 한 줄로 됩니다. EXPLAIN을 붙여 type과 key만 보면 인덱스를 탔는지 바로 나옵니다.
이 글을 다 읽으면 세 가지가 정리됩니다. 첫째, EXPLAIN 결과에서 볼 컬럼 네 개를 알 수 있습니다. 둘째, 인덱스를 못 쓰게 만드는 대표 5가지 패턴을 내 쿼리에서 찾을 수 있습니다. 셋째, 복합 인덱스의 컬럼 순서를 정하는 기준을 확인할 수 있습니다.
이 글은 MySQL 공식 문서를 기준으로 정리했습니다. 버전과 데이터 분포에 따라 옵티마이저 판단이 달라질 수 있습니다.
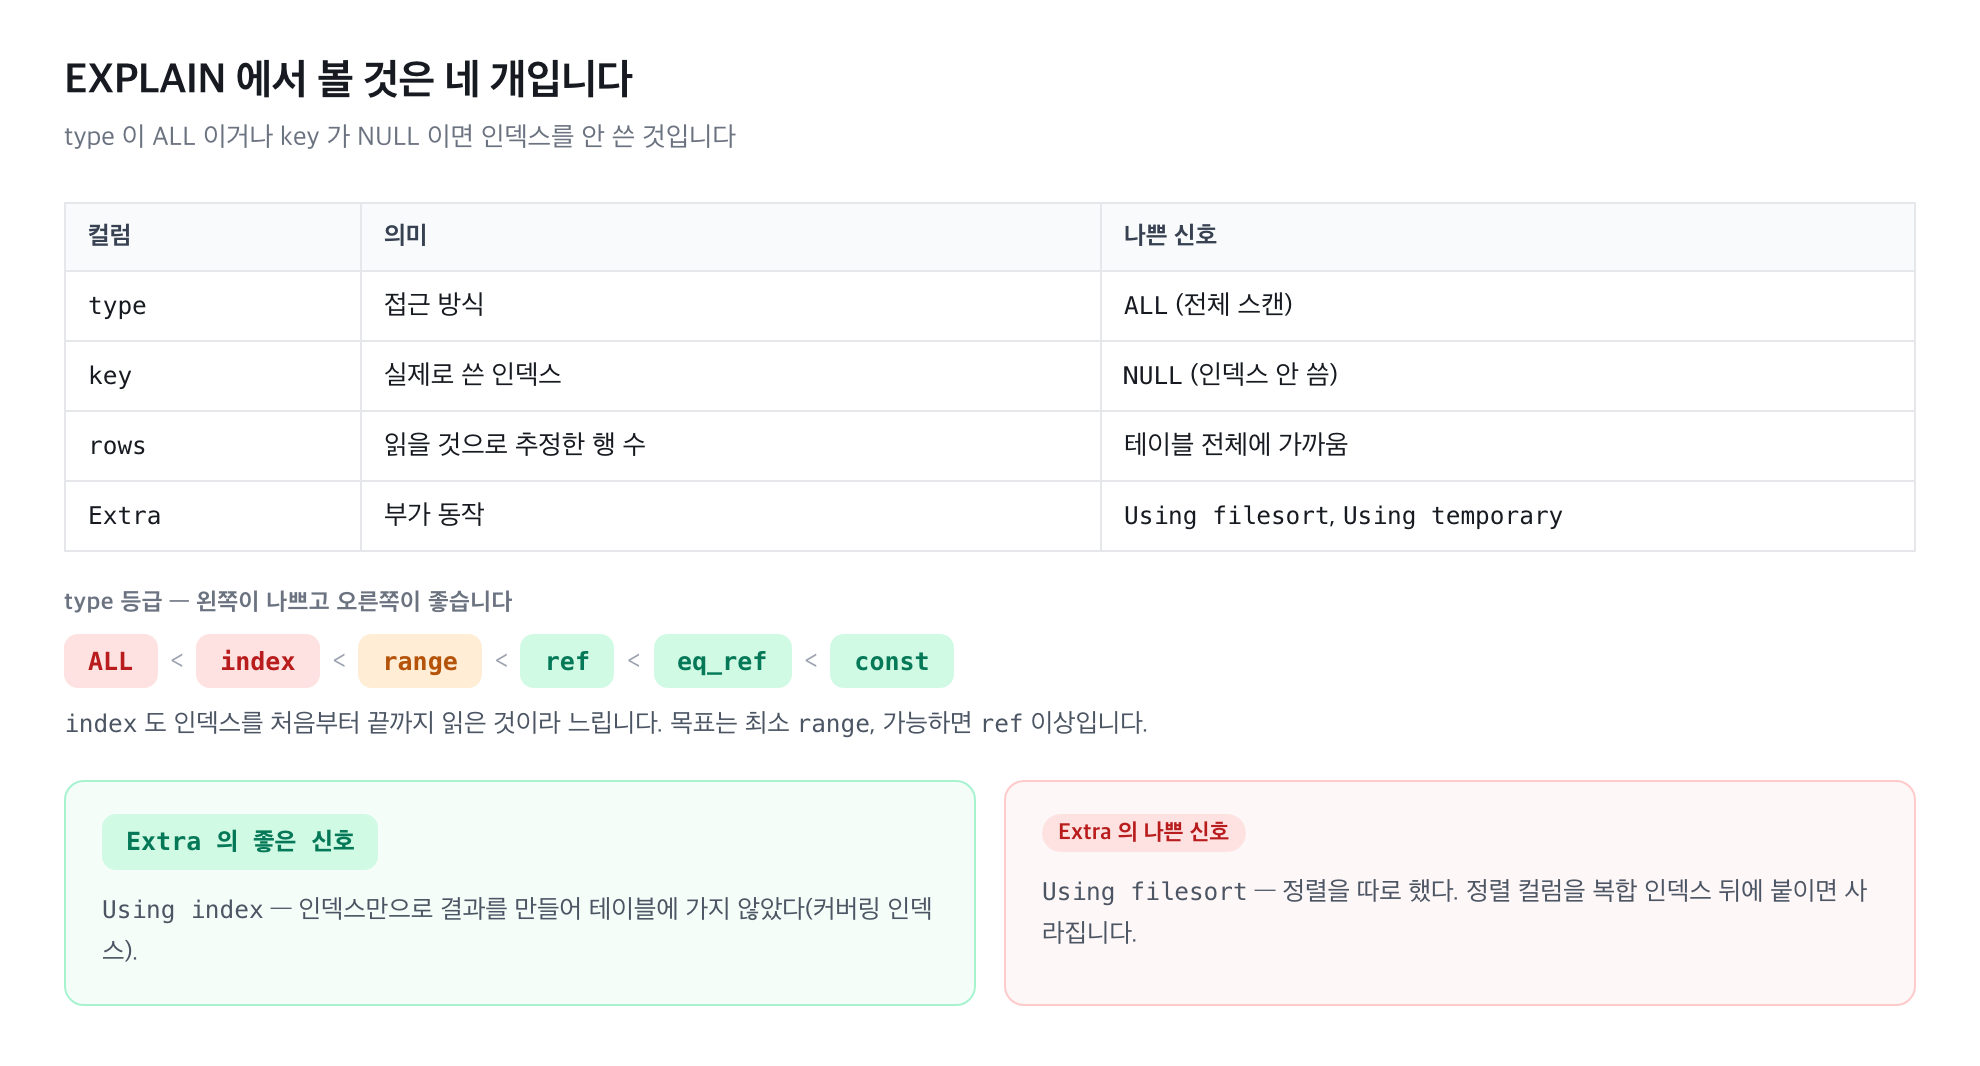
EXPLAIN에서 먼저 볼 네 컬럼과 type 등급
EXPLAIN에서 볼 것은 네 개입니다
EXPLAIN SELECT * FROM orders
WHERE user_id = 100 AND status = 'PAID'
ORDER BY created_at DESC LIMIT 20;
출력이 넓지만 실무에서 보는 건 이 네 개입니다.
| 컬럼 | 의미 | 나쁜 신호 |
|---|---|---|
type |
접근 방식 | ALL(전체 스캔) |
key |
실제로 쓴 인덱스 | NULL(인덱스 안 씀) |
rows |
읽을 것으로 추정한 행 수 | 테이블 전체에 가까움 |
Extra |
부가 동작 | Using filesort, Using temporary |
type은 대략 이런 순서로 좋아집니다.
ALL  <  index  <  range  <  ref  <  eq_ref  <  const
전체스캔 인덱스 전체 범위 비고유 일치 고유 일치 상수ALL이면 인덱스를 아예 안 쓴 것이고, index는 인덱스를 처음부터 끝까지 읽은 것이라 역시 느립니다. 목표는 최소 range, 가능하면 ref 이상입니다.
Extra의 Using index는 좋은 신호입니다. 인덱스만으로 결과를 만들어서 테이블에 가지 않았다는 뜻(커버링 인덱스)입니다. 반대로 Using filesort는 정렬을 메모리·디스크에서 따로 했다는 뜻입니다.
MySQL 공식 문서의 EXPLAIN 출력 형식 설명 (출처: dev.mysql.com, 확인일 2026-08-14)
경우 1 — 컬럼에 함수나 연산을 씌웠다
가장 흔합니다. 인덱스는 컬럼의 원래 값으로 정렬돼 있으므로, 컬럼을 가공하면 그 순서를 쓸 수 없습니다.
-- ❌ created_at 인덱스를 못 쓴다
SELECT * FROM orders WHERE DATE(created_at) = '2026-08-14';

-- ✅ 범위 조건으로 바꾼다
SELECT * FROM orders
WHERE created_at >= '2026-08-14 00:00:00'
  AND created_at <  '2026-08-15 00:00:00';
-- ❌ 연산이 컬럼 쪽에 있다
SELECT * FROM products WHERE price * 1.1 > 11000;
-- ✅ 상수 쪽으로 옮긴다
SELECT * FROM products WHERE price > 10000;SUBSTRING(name, 1, 3) = 'ABC'도 같은 문제입니다. 앞자리 검색이라면 name LIKE 'ABC%'로 바꾸면 인덱스를 씁니다.
경우 2 — 복합 인덱스의 앞 컬럼을 빼먹었다
복합 인덱스는 왼쪽부터 순서대로 쓸 수 있습니다. (user_id, status, created_at) 인덱스가 있다면 이렇게 갈립니다.
-- ✅ 사용 (user_id)
WHERE user_id = 100

-- ✅ 사용 (user_id, status)
WHERE user_id = 100 AND status = 'PAID'

-- ❌ 사용 불가 — 선행 컬럼 user_id 가 없다
WHERE status = 'PAID'

-- △ 부분 사용 — user_id 까지만 쓰고 created_at 은 범위 이후라 제한적
WHERE user_id = 100 AND created_at > '2026-08-01'status만으로 조회하는 화면이 자주 있다면 (status, ...) 인덱스를 따로 만들어야 합니다. 컬럼 순서만 바꾼 인덱스는 다른 인덱스입니다.
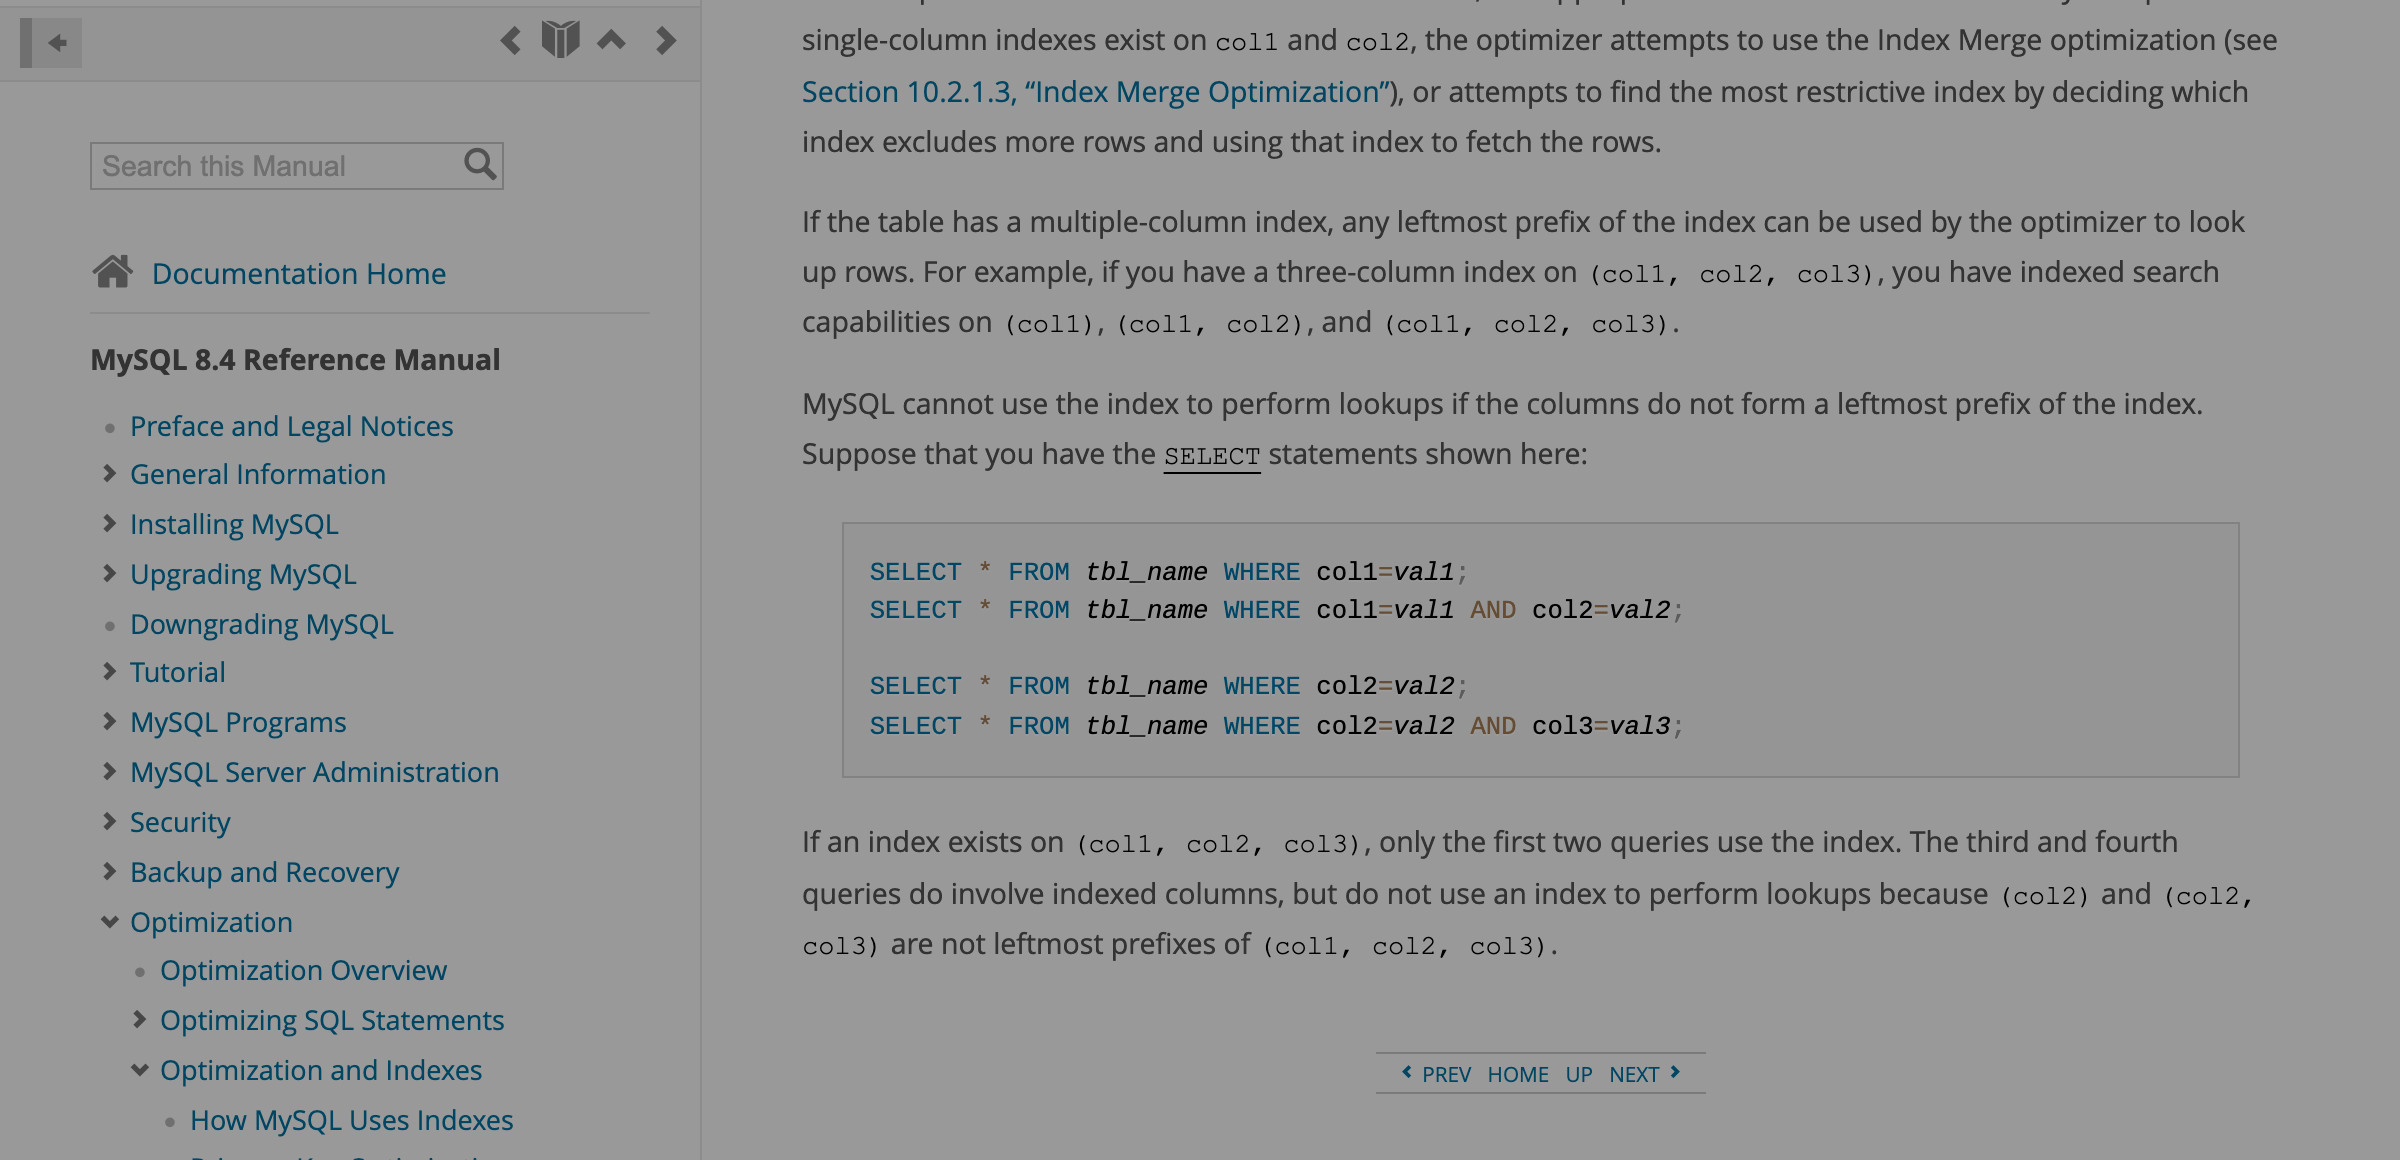
MySQL 공식 문서 — 복합 인덱스는 왼쪽 접두어부터 사용됩니다 (출처: dev.mysql.com, 확인일 2026-08-14)
경우 3 — 타입이나 콜레이션이 다르다
조용히 느려지는 유형입니다. 컬럼이 문자열인데 숫자로 비교하면 MySQL이 형변환을 하면서 인덱스를 못 씁니다.
-- user_code 가 VARCHAR 인 경우
-- ❌ 숫자로 비교 → 암묵적 형변환
SELECT * FROM users WHERE user_code = 12345;

-- ✅ 문자열로 비교
SELECT * FROM users WHERE user_code = '12345';
조인에서도 같은 일이 생깁니다. orders.user_id가 BIGINT인데 users.id가 INT이거나, 한쪽이 utf8mb4_general_ci이고 다른 쪽이 utf8mb4_unicode_ci이면 조인 컬럼의 인덱스를 못 씁니다.
-- 컬럼 타입과 콜레이션 확인
SHOW FULL COLUMNS FROM orders;
SHOW FULL COLUMNS FROM users;
경우 4 — LIKE 앞에 와일드카드가 있다
-- ❌ 앞이 열려 있으면 정렬 순서를 쓸 수 없다
SELECT * FROM products WHERE name LIKE '%마우스%';

-- ✅ 앞이 고정되면 범위 검색이 된다
SELECT * FROM products WHERE name LIKE '마우스%';
앞뒤로 열린 검색이 꼭 필요하면 방법이 달라집니다. 전문 검색 인덱스(FULLTEXT) 를 쓰거나, 검색 전용 엔진을 두거나, 역순 문자열 컬럼을 추가로 만들어 접두어 검색으로 바꾸는 식입니다. 인덱스를 더 만들어서 해결되는 문제가 아닙니다.
경우 5 — 옵티마이저가 일부러 안 쓴다
인덱스를 쓸 수 있는데도 전체 스캔을 고르는 경우가 있습니다. 인덱스로 찾은 뒤 테이블에서 실제 행을 다시 읽는 비용이 크다고 판단할 때입니다.
전형적인 상황들입니다.
- 카디널리티가 낮다 —
status값이 두 종류뿐이고 그중 하나가 90%라면, 그 값을 찾을 때는 전체 스캔이 더 빠릅니다. - 결과가 테이블의 상당 비율이다 — 흔히 20~30%를 넘어가면 전체 스캔이 유리해집니다.
OR로 서로 다른 컬럼을 묶었다 — 각각 인덱스가 있어도 합치는 비용이 커집니다.UNION ALL로 나누면 각 인덱스를 쓸 수 있습니다.- 부정 조건이다 —
!=,NOT IN,IS NOT NULL은 범위를 좁혀 주지 못해 전체 스캔이 되기 쉽습니다. - 통계가 낡았다 — 데이터가 크게 바뀐 뒤 통계를 갱신하지 않으면 잘못 판단합니다.
-- OR 을 UNION ALL 로 분리
SELECT * FROM orders WHERE user_id = 100
UNION ALL
SELECT * FROM orders WHERE coupon_id = 55 AND user_id <> 100;

-- 통계 갱신
ANALYZE TABLE orders;
다섯 가지 패턴과 각각의 수정 방향
복합 인덱스 컬럼 순서 정하는 기준
새로 만들 때 순서는 이 원칙으로 정합니다.
1) 등호(=) 조건으로 쓰는 컬럼을 앞에
2) 범위(>, <, BETWEEN) 조건 컬럼을 그다음에
3) ORDER BY 컬럼을 마지막에
4) 같은 조건이면 카디널리티가 높은(값이 다양한) 컬럼을 앞에
앞의 예시 쿼리에 맞추면 이렇게 됩니다.
-- WHERE user_id = ? AND status = ?  ORDER BY created_at DESC
CREATE INDEX idx_orders_user_status_created
    ON orders (user_id, status, created_at);
이 순서면 user_id·status로 좁히고 created_at 순서를 그대로 읽으므로 Using filesort가 사라집니다. 범위 조건 컬럼을 중간에 두면 그 뒤 컬럼은 정렬에 쓰이지 못한다는 점만 기억하시면 됩니다.
확인에 쓰는 명령
-- 실행 계획 (실행하지 않음)
EXPLAIN SELECT ...;

-- 실제로 실행하며 시간·행 수 측정 (MySQL 8.0.18+)
EXPLAIN ANALYZE SELECT ...;

-- 테이블의 인덱스와 카디널리티
SHOW INDEX FROM orders;

-- 실제로 안 쓰이는 인덱스 찾기 (performance_schema 활성 필요)
SELECT * FROM sys.schema_unused_indexes;

-- 통계 갱신
ANALYZE TABLE orders;
EXPLAIN ANALYZE는 추정치가 아니라 실제 측정치를 보여 주므로, rows 추정이 크게 틀렸는지 확인할 때 특히 유용합니다.
확인 순서
- [ ] 느린 쿼리에
EXPLAIN을 붙여 type과 key를 확인한다 - [ ]
WHERE절에서 컬럼에 함수·연산이 붙어 있는지 본다 - [ ] 복합 인덱스라면 선행 컬럼이 조건에 있는지 확인한다
- [ ] 비교 값과 컬럼의 타입·콜레이션이 같은지 확인한다
- [ ]
LIKE가%로 시작하지 않는지 확인한다 - [ ]
OR·부정 조건을 쓰고 있으면 분리 가능한지 검토한다 - [ ]
ANALYZE TABLE로 통계를 갱신한 뒤 다시 본다 - [ ]
Extra에Using filesort가 있으면 정렬 컬럼을 인덱스 뒤에 붙인다
다음에 볼 글
애플리케이션 쪽에서 쿼리가 늘어나는 문제는 따로 정리해 두었습니다. 컬렉션 조회에서 나는 LazyInitializationException과 MultipleBagFetchException, 그리고 트랜잭션 경계를 다룬 @Transactional이 안 먹는 경우입니다.
잘못된 내용이나 보충이 필요한 부분이 있으면 댓글로 알려 주시면 반영하겠습니다.
참고한 자료
- MySQL Reference Manual — EXPLAIN Output Format (
type·key·rows·Extra) (확인일 2026-08-14) - MySQL Reference Manual — How MySQL Uses Indexes, Multiple-Column Indexes(왼쪽 접두어) (확인일 2026-08-14)
- MySQL Reference Manual —
EXPLAIN ANALYZE,ANALYZE TABLE,SHOW INDEX(확인일 2026-08-14) - MySQL Reference Manual — Comparison of Rows and Type Conversion (확인일 2026-08-14)


